Refuser l'entraînement des IA : la règle robots.txt commune
Si tu as un blog, une chaîne ou un site, une question te concerne : les IA ont-elles le droit de lire tes pages pour s'entraîner ? Jusqu'ici, la réponse était un casse-tête, avec une consigne différente pour chaque robot. Fin octobre 2026, les grands acteurs ont commencé à se mettre d'accord sur une seule ligne pour dire non.
Attention : c'est un progrès réel, mais il y a des trous. On fait le tri.
Ce qu'il faut retenir
- Un brouillon de norme déposé le 30 octobre 2026 à l'IETF propose une consigne unique dans
robots.txt:__usage_ai-training. - Il a été écrit par Kevin Kelley, ingénieur chez Anthropic, et reçoit le soutien de Google, OpenAI et Microsoft.
- Ce n'est pas encore une norme officielle : c'est une proposition en discussion.
- Si tu ne mets rien dans ton fichier, l'entraînement reste autorisé par défaut.
- Cette règle ne parle que de l'entraînement, pas de l'affichage de ton contenu dans les réponses IA.
C'est quoi, robots.txt ?
Chaque site peut avoir à sa racine un petit fichier texte, robots.txt. Il indique aux robots (ceux de Google, de Bing, etc.) ce qu'ils peuvent visiter. C'est un règlement affiché à la porte : les robots honnêtes le respectent, mais rien ne les y oblige techniquement.
Le problème avec l'IA : chaque entreprise avait son propre nom de robot à bloquer (GPTBot chez OpenAI, Google-Extended chez Google...). Il fallait connaître la liste et la mettre à jour.
La nouveauté : une seule ligne pour tout le monde
Le brouillon, appelé draft-kelley-aipref-training-preference-signal, est discuté dans le groupe de travail AIPREF de l'IETF, l'organisme qui standardise une partie d'Internet. Son idée est simple : au lieu d'un nom de robot, on utilise un « nom » commun, __usage_ai-training, à la place d'un robot dans la ligne User-agent.
Concrètement :
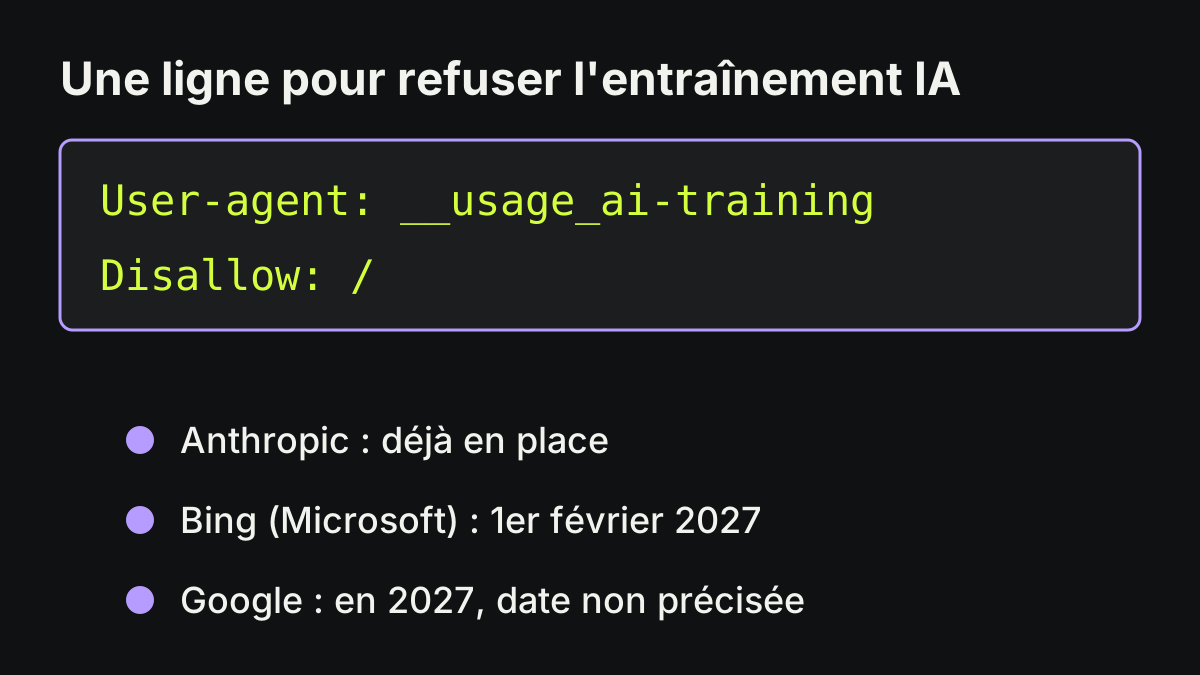
User-agent: __usage_ai-training
Disallow: /
Ça veut dire « n'utilisez aucune page de ce site pour entraîner une IA générative ». À l'inverse, un Allow autorise. Comme pour un robots.txt normal, tu peux faire du cas par cas : tout refuser, sauf un dossier, par exemple ta page presse.
Qui s'y met, et quand ?
D'après Blog du Modérateur, les calendriers diffèrent selon les entreprises :
- Anthropic applique déjà le signal et l'étend à tous ses services.
- OpenAI prévoit de le respecter « dans les prochains mois ».
- Microsoft : Bing s'y conformera à partir du 1er février 2027.
- Google : prise en charge en 2027, sans date précise.
Pour Google, un refus via la règle commune bloque Google-Extended, sauf si tu as défini une règle spécifique pour ce robot.
Ce que ça ne règle pas
Voilà ce que le buzz oublie souvent.
Ce n'est pas une obligation légale. Comme tout robots.txt, ça repose sur la bonne volonté des entreprises. Un acteur qui ne signe pas le pacte peut l'ignorer.
Ça ne change rien au passé. Les contenus déjà utilisés pour entraîner des modèles ne sont pas retirés.
Ça ne contrôle pas l'affichage. Refuser l'entraînement ne bloque pas forcément l'apparition de ton site dans les réponses IA, comme les AI Overviews de Google ou Copilot : ces réglages sont séparés. Microsoft précise que ton site reste éligible aux résultats Bing quel que soit ton choix.
Les blocages existants restent séparés. Tes règles actuelles sur GPTBot ou Google-Extended continuent de fonctionner, indépendamment de la nouvelle ligne.
Pourquoi c'est important maintenant
Ce n'est pas un hasard si ça arrive en ce moment. Les éditeurs s'agacent : le même jour, cinq organisations françaises d'éditeurs ont déposé plainte contre Google à propos de ses réponses IA et de leur impact sur le trafic. Et les sites se ferment de plus en plus aux robots, comme on l'a vu avec les agents IA bloqués par Amazon ou JPMorgan. Les géants de l'IA ont intérêt à offrir un moyen simple de refuser, avant que la loi ne l'impose.
Alors, ça change quoi ?
Si tu publies du contenu, c'est une bonne nouvelle : à terme, une ligne suffira pour exprimer ton choix, au lieu d'une liste de robots à suivre. Mais rien ne sera réellement effectif partout avant 2027, et la norme n'est pas encore validée.
Si tu ne publies rien, ça te concerne quand même : c'est un signe que la question du « droit de s'entraîner sur nos contenus » est en train de passer des tribunaux vers des règles techniques communes.
Préparé avec l'aide de l'IA à partir des sources, puis relu et validé par Valentin Fouilloud avant publication. Comment on travaille