OpenAI : sa preuve de maths a-t-elle émis 1 000 tonnes de CO2 ?
Verdict : À moitié
Début septembre 2026, OpenAI a annoncé que son IA avait résolu un problème de maths réputé parmi les plus durs du monde, les équations de Navier-Stokes. Dix mille agents IA ont travaillé 88 heures d'affilée. Victor Charpenay, enseignant-chercheur à Mines Saint-Étienne, a estimé dans The Conversation le 12 novembre que ce calcul a émis plus de 1 000 tonnes équivalent CO2, soit l'empreinte annuelle d'environ 100 chercheurs européens.
Ce qu'il faut retenir
- L'estimation part du nombre de mots générés par l'IA (130 milliards de tokens), faute de données d'OpenAI sur sa consommation.
- Elle donne environ 500 tonnes de CO2 pour la preuve seule, et plus de 1 000 tonnes en comptant les essais ratés.
- L'auteur reconnaît lui-même des « hypothèses fragiles » : le chiffre peut être loin du vrai, dans un sens ou dans l'autre.
- La preuve elle-même est encore discutée par les mathématiciens.
Navier-Stokes, c'est quoi ce problème ?
Ce sont les équations qui décrivent comment bougent les fluides : l'eau dans un tuyau, l'air autour d'une aile d'avion, la fumée d'une bougie. On s'en sert depuis le XIXe siècle, mais personne n'avait prouvé qu'elles ont toujours une solution « propre », sans valeur qui part à l'infini. Le Clay Mathematics Institute en a fait l'un de ses sept problèmes du millénaire, avec un million de dollars à la clé.
OpenAI a publié sa preuve le 8 septembre, avec une version vérifiable par Lean, un logiciel qui contrôle les démonstrations ligne par ligne. L'entreprise a dit qu'elle ne réclamerait pas le prix. Des mathématiciens font remarquer que le résultat porte sur une version des équations avec une force extérieure, alors que l'énoncé du Clay Institute vise la version sans force. Un chercheur de l'université de New York accuse aussi OpenAI de s'être pressée pour devancer un travail concurrent. Le débat est donc ouvert sur la portée réelle du résultat, indépendamment de son coût.
Le calcul des 1 000 tonnes, étape par étape
OpenAI n'a pas dit combien d'électricité ses 10 000 agents ont consommée. Victor Charpenay a donc reconstruit une estimation à partir de ce que l'entreprise a publié.
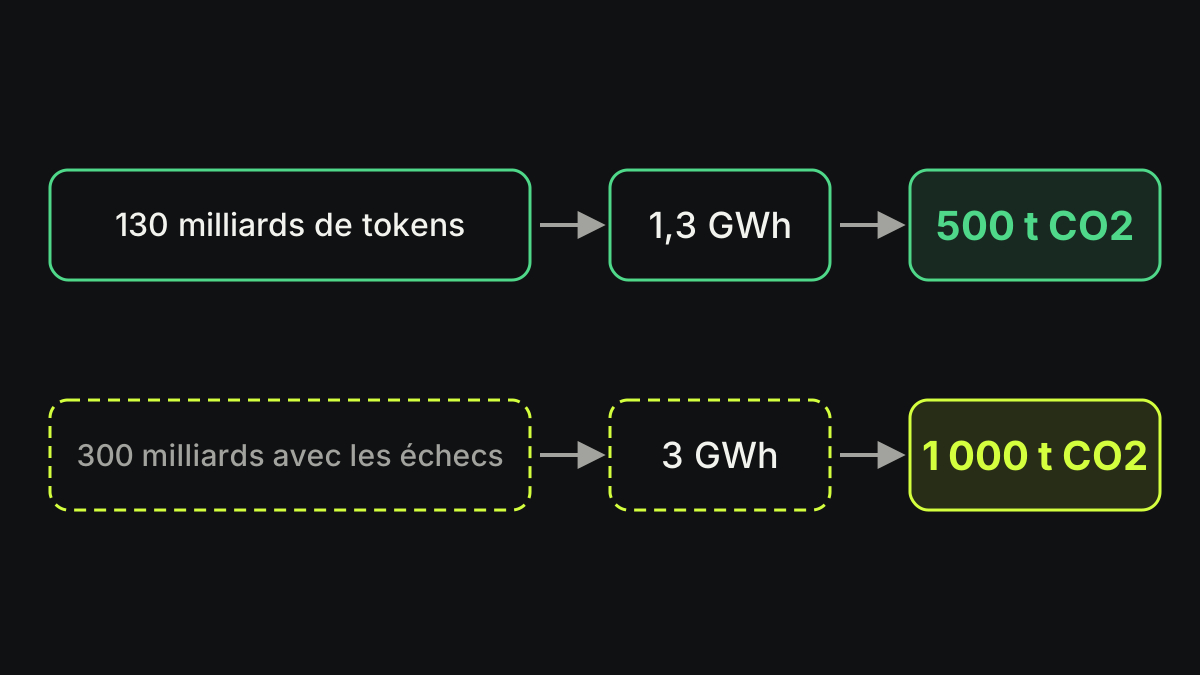
- Compter ce que l'IA a écrit. Selon OpenAI, les agents ont échangé 2,7 millions de messages et produit environ 130 milliards de tokens (des morceaux de mots, l'unité de base d'un modèle de langage). Pour comparer, la saga Harry Potter complète compte environ un million de mots : l'IA en a écrit l'équivalent de près de 100 000 fois.
- Trouver le coût d'un token. Le modèle d'OpenAI est secret. L'auteur prend donc les mesures de Neuralwatt sur un modèle ouvert, Kimi K3 : 33,6 kilojoules pour 1 000 tokens, soit environ 10 wattheures. C'est ce que consomme une ampoule LED allumée une heure.
- Multiplier. 130 milliards de tokens à ce tarif donnent environ 1,3 gigawattheure.
- Convertir en CO2. Avec l'intensité carbone moyenne de l'électricité américaine en 2026, 388 grammes par kilowattheure, on arrive à environ 500 tonnes équivalent CO2.
- Ajouter les essais ratés. OpenAI a fait tourner ses agents sur d'autres problèmes sans dire s'ils avaient abouti. L'auteur estime le total à environ 300 milliards de tokens, soit 3 gigawattheures et plus de 1 000 tonnes.
Les 500 tonnes de la preuve seule équivalent à l'empreinte carbone annuelle d'environ 50 Européens. Les 1 000 tonnes, à celle d'une centaine de mathématiciens pendant un an. L'auteur ajoute un repère côté budget : le coût du calcul équivaudrait au financement d'une quarantaine de bourses de thèse en France.
Pourquoi Kimi K3 fausse peut-être tout
L'étape 2 porte presque tout le résultat. Si le modèle d'OpenAI consomme deux fois moins par token que Kimi K3, l'empreinte est divisée par deux. S'il est plus gros, elle grimpe. Personne hors d'OpenAI ne peut vérifier.
L'auteur signale une autre faiblesse : la consommation d'un modèle dépend surtout de la durée de calcul, plus que du nombre de tokens produits. Un modèle qui « réfléchit » longtemps avant d'écrire peut brûler beaucoup d'énergie pour peu de texte. Or le calcul ne modélise pas cette durée. Enfin, l'intensité carbone de 388 g/kWh est une moyenne nationale ; un data center alimenté par du gaz émettrait plus, un autre branché sur du nucléaire ou de l'hydraulique bien moins.
Google et OpenAI ont déjà contesté par le passé des estimations universitaires de la consommation de leurs modèles. La seule façon de trancher serait qu'OpenAI publie ses propres chiffres.
1 000 tonnes, c'est beaucoup ?
Pour un seul résultat scientifique, oui. L'auteur compare avec la physique : le réseau d'antennes radio GRAND représente 471 tonnes équivalent CO2, et un grand télescope Tcherenkov entre 2 400 et 2 950 tonnes sur toute sa vie de 30 ans. La preuve d'OpenAI pèserait autant que dix à quinze ans de fonctionnement d'un tel télescope, en 88 heures.
À l'échelle de l'IA, en revanche, c'est petit. Les grands data centers se mesurent en centaines de mégawatts. Un site de 1 000 MW, la puissance qu'OpenAI promet de pouvoir couper sur son data center en Géorgie, consomme 3 GWh en trois heures à pleine charge.
Le mot « astronomique » du titre de The Conversation est donc juste face au travail d'un chercheur, et exagéré face au reste de l'industrie. Le chiffre de 1 000 tonnes est un ordre de grandeur plausible, construit honnêtement, mais qui repose sur un modèle de remplacement que rien ne permet de valider. On le classe à moitié vrai tant qu'OpenAI ne publie pas sa consommation réelle.
Préparé avec l'aide de l'IA à partir des sources, puis relu et validé par Valentin Fouilloud avant publication. Comment on travaille