Actus du 2 novembre : Anthropic, robots.txt et NYT contre Brave
Lundi 2 novembre : des chiffres vertigineux chez Anthropic, une règle commune pour dire non à l'entraînement des IA, et un procès qui vise le navigateur Brave.
Anthropic dévoile 17 milliards de dollars de revenus en un trimestre
Le 2 novembre, Anthropic a déposé une version mise à jour de son dossier de Bourse (le « S-1 »), qui ne couvrait au départ que le premier semestre. Il en ressort environ 17 milliards de dollars de revenus au troisième trimestre, mais aussi une perte nette de 23,29 milliards sur la période. La croissance ralentit : +47 % par rapport au trimestre précédent, contre +144 % au deuxième. Anthropic s'est aussi engagée sur environ 895 milliards de dollars de dépenses, presque toutes liées au calcul et aux infrastructures. Pourquoi ça compte : tu vois enfin ce que coûte vraiment un chatbot à grande échelle. Source : CNBC
Google, OpenAI et Microsoft soutiennent un robots.txt commun contre l'entraînement des IA
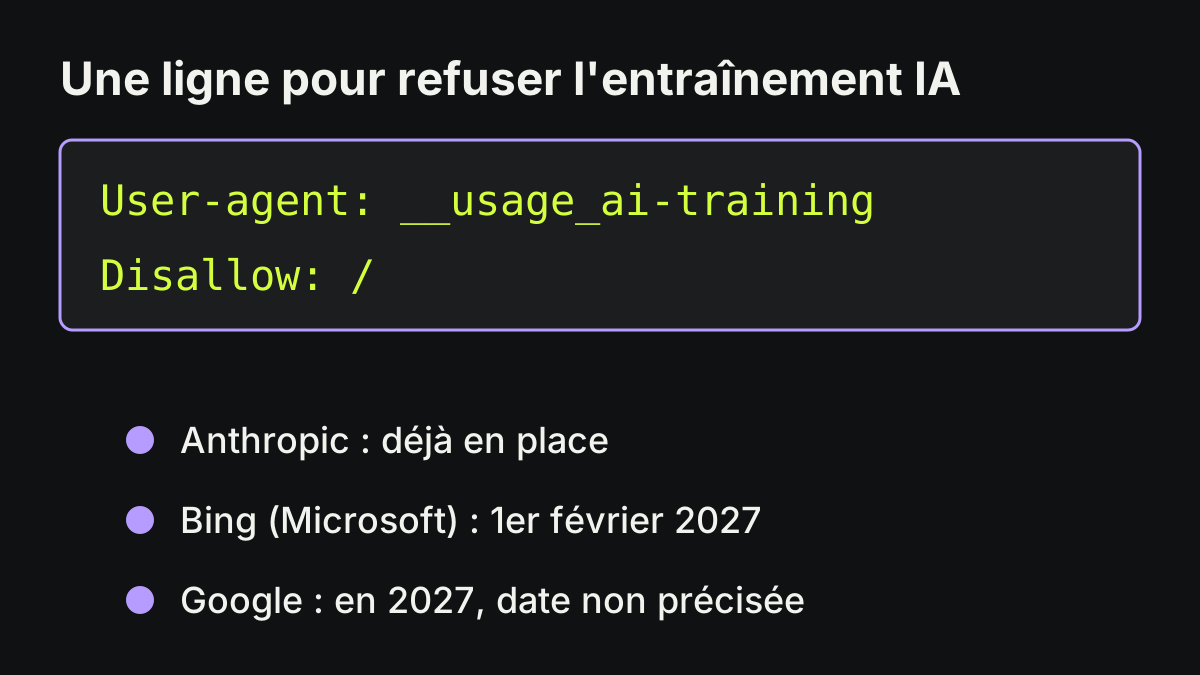
Un brouillon de norme déposé le 30 octobre à l'IETF par un ingénieur d'Anthropic propose une seule ligne, __usage_ai-training, pour refuser que ses pages servent à entraîner une IA. Google, OpenAI et Microsoft ont accepté de la respecter. Les dates varient : Anthropic l'applique déjà, Bing à partir du 1er février 2027, Google en 2027 sans date précise. Rien n'est obligatoire, et l'affichage dans les réponses IA n'est pas concerné. Pourquoi ça compte : si tu publies des vidéos, un blog ou du code, tu auras bientôt un moyen simple de dire non. Source : Blog du Modérateur
Le New York Times attaque le navigateur Brave
Le 2 novembre, le New York Times a poursuivi Brave devant un tribunal fédéral de Manhattan. Le Daily News, le Chicago Tribune et l'Orlando Sentinel ont déposé une plainte similaire. Ils accusent Brave d'avoir copié leurs articles pour les revendre à des entreprises d'IA, et de contourner leurs paywalls. Brave n'avait pas encore répondu à la date de l'article. Ce sont des accusations, pas un jugement. Pourquoi ça compte : la bataille sur les contenus qui nourrissent l'IA se joue maintenant devant les juges, et elle décidera ce que les IA pourront apprendre. Source : TechCrunch
OpenAI promet qu'un futur data center pourra lever le pied
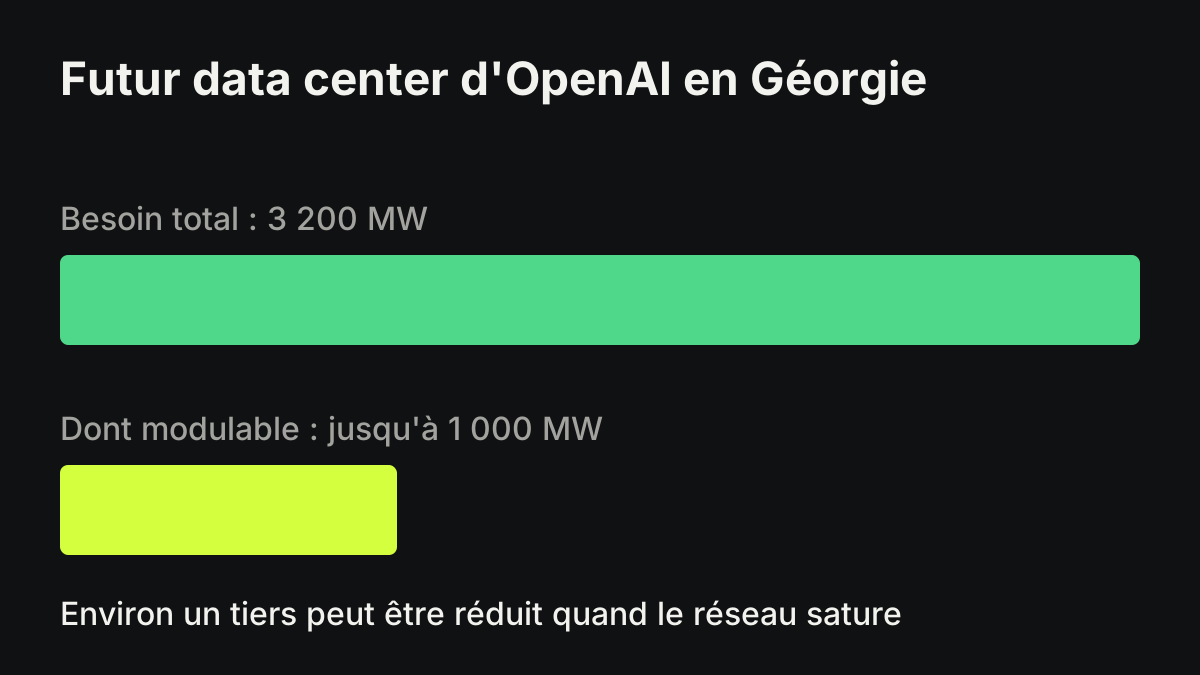
Dans l'Effingham County, en Géorgie, OpenAI prévoit un site qui devrait consommer environ 3 200 mégawatts. Selon Georgia Power, l'entreprise s'est engagée, dans un accord de 25 ans, à fournir jusqu'à 1 000 MW de flexibilité : l'électricien pourra réduire l'énergie livrée au site à certains moments. Les conditions précises (durée, fréquence) ne sont pas détaillées, et le contrat doit encore être examiné par le régulateur. Pourquoi ça compte : la question des data centers n'est plus seulement « combien », mais « quand » ils consomment. Source : Georgia Power
L'Italie veut plafonner le prix du gaz de ses centrales
Rome compte plafonner à environ 59 €/MWh le gaz consommé par ses centrales électriques, pour au moins un an, sur le modèle de l'exception ibérique de 2022. L'objectif affiché : une baisse de 10 % sur les factures des ménages dont le contrat suit les prix de gros. La Commission européenne a donné un accord de principe, mais l'Italie doit encore notifier l'aide d'État et espère l'appliquer en janvier 2027. Eurelectric critique des subventions déguisées aux centrales à gaz. Pourquoi ça compte : le gaz fixe le prix de l'électricité plus de 70 % du temps en Italie, contre 20 % en France. Source : Révolution Énergétique
ChatGPT et Codex partageront bientôt le même quota
Dans un e-mail aux abonnés, OpenAI annonce que l'usage de ChatGPT et de Codex (son outil de programmation) sera décompté d'un seul quota commun. Pour les forfaits Plus, Pro et Business, le changement doit arriver en décembre. Les conversations avec le modèle Instant ne comptent pas dans ce quota. Une bêta qui fusionne les onglets Chat et Work est prévue dans les prochaines semaines, sans date de déploiement général. Pourquoi ça compte : si tu codes avec Codex, tu risques d'atteindre plus vite ta limite, car ces tâches consomment beaucoup plus qu'une simple discussion. Source : Siècle Digital
Préparé avec l'aide de l'IA à partir des sources, puis relu et validé par Valentin Fouilloud avant publication. Comment on travaille